Die vier Säulen des zuverlässigen agentischen Marketings: Marken brauchen eine verifizierte Datenquelle
Die meisten Plattformen decken nur eine der vier Säulen ab. Folgendes sollte jede Führungskraft im Marketing wissen, bevor sie KI-Agenten agieren lässt.


Dies ist der zweite Teil einer fünfteiligen Reihe über agentisches Marketing. Klicken Sie hier, um Teil eins zu lesen.
Die zweite Säule des agentischen Marketings: die verifizierte Datenquelle
Analysen zeigen Ihnen, wo Sie stehen und was sich ändern muss. Doch das Wissen um das Problem allein führt nicht zu dessen Lösung. Das bringt uns zur nächsten tragenden Säule des agentischen Marketings: der verifizierten Datenquelle. Marken benötigen eine einzige, maßgebliche Quelle zur Speicherung und Strukturierung ihrer Informationen und um den KI-Agenten eine geeignete Grundlage zu bieten, von der aus sie all diese Daten anschließend verteilen können.
Was ist eine verifizierte Datenquelle?
Eine verifizierte Datenquelle ist ein einziges, strukturiertes Repository mit korrekten, aktuellen Daten für jeden Standort im Portfolio einer Marke. Die Felder sind auf schema.org abgestimmt – die Standardsprache, die KI-Modelle zur Interpretation von Markendaten verwenden. Wenn Agenten dann eine Aufgabe ausführen müssen (sei es die Reaktion auf Wettbewerbslücken oder die Aktualisierung von Standortinformationen), können sie sich auf diese eine Quelle statt auf ein Dutzend fragmentierter Systeme stützen.
Die Wahrheit? Selbst im Jahr 2026 verfügen die meisten Marken nicht darüber. Ihre Standortdaten sind über Google Unternehmensprofile, ihre Website, E-Commerce-Plattformen, ihr POS-System, lokal abgelegte Tabellen und vieles mehr verstreut. Jedes System behauptet, die zentrale Datenquelle zu sein – bis sich herausstellt, dass dies nicht der Fall ist. Und oft stimmen diese Daten nicht miteinander überein.
Warum KI eine verlässliche Grundlage braucht
Die grundlegende Antwort ist einfach: Marketingverantwortliche würden nicht wollen, dass eine Nachwuchskraft eigenmächtige Entscheidungen trifft oder Aktualisierungen auf der Grundlage falscher oder unbestätigter Informationen veröffentlicht. Warum sollten sie dies dann einem KI-Agenten gestatten? Bei jeder von einem Agenten initiierten Aufgabe oder jeder von ihm gegebenen Antwort stellt die Nutzung einer zentralen, genehmigten Datenquelle sicher, dass widersprüchliche Informationen nicht zu kostspieligen Fehlern führen. (Mehr hierzu in Säule drei, „Inhalt und Verbreitung“.)
Der zweite Grund ist technischer Natur. Eine zentrale Plattform für strukturierte und KI-fähige Daten, die wiederum in der Sprache bereitgestellt werden, die LLMs bereits „sprechen“, hilft der KI bei der zuverlässigen Analyse, Einordnung und Darstellung eines Unternehmens. Dies ist der grundlegende Schlüssel für Führungskräfte, die sicherstellen möchten, dass ihre Marke überall dort mit präzisen Antworten präsent ist, wo Ergebnisse generiert werden.
Wie der Yext Knowledge Graph Marken den entscheidenden Vorteil verschafft
Der Yext Knowledge Graph wurde genau aus diesem Grund entwickelt.
Marken, die mit Yext einen einheitlichen Knowledge Graph aufbauen, verschaffen sich einen strukturellen Vorteil: schnellere Umsetzung, mehr Einheitlichkeit, bessere KI-Sichtbarkeit. Mit dem Knowledge-Graph-Modell können Marken nämlich die reale Welt abbilden, indem sie komplexe Beziehungen zwischen Standorten, Fachkräften, Produkten, Dienstleistungen und vielem mehr als strukturierte Entitäten und Felder definieren. Diese Verbindungen liefern sowohl internen KI-Agenten als auch LLMs den grundlegenden Kontext, den sie zum Verständnis einer Marke benötigen.
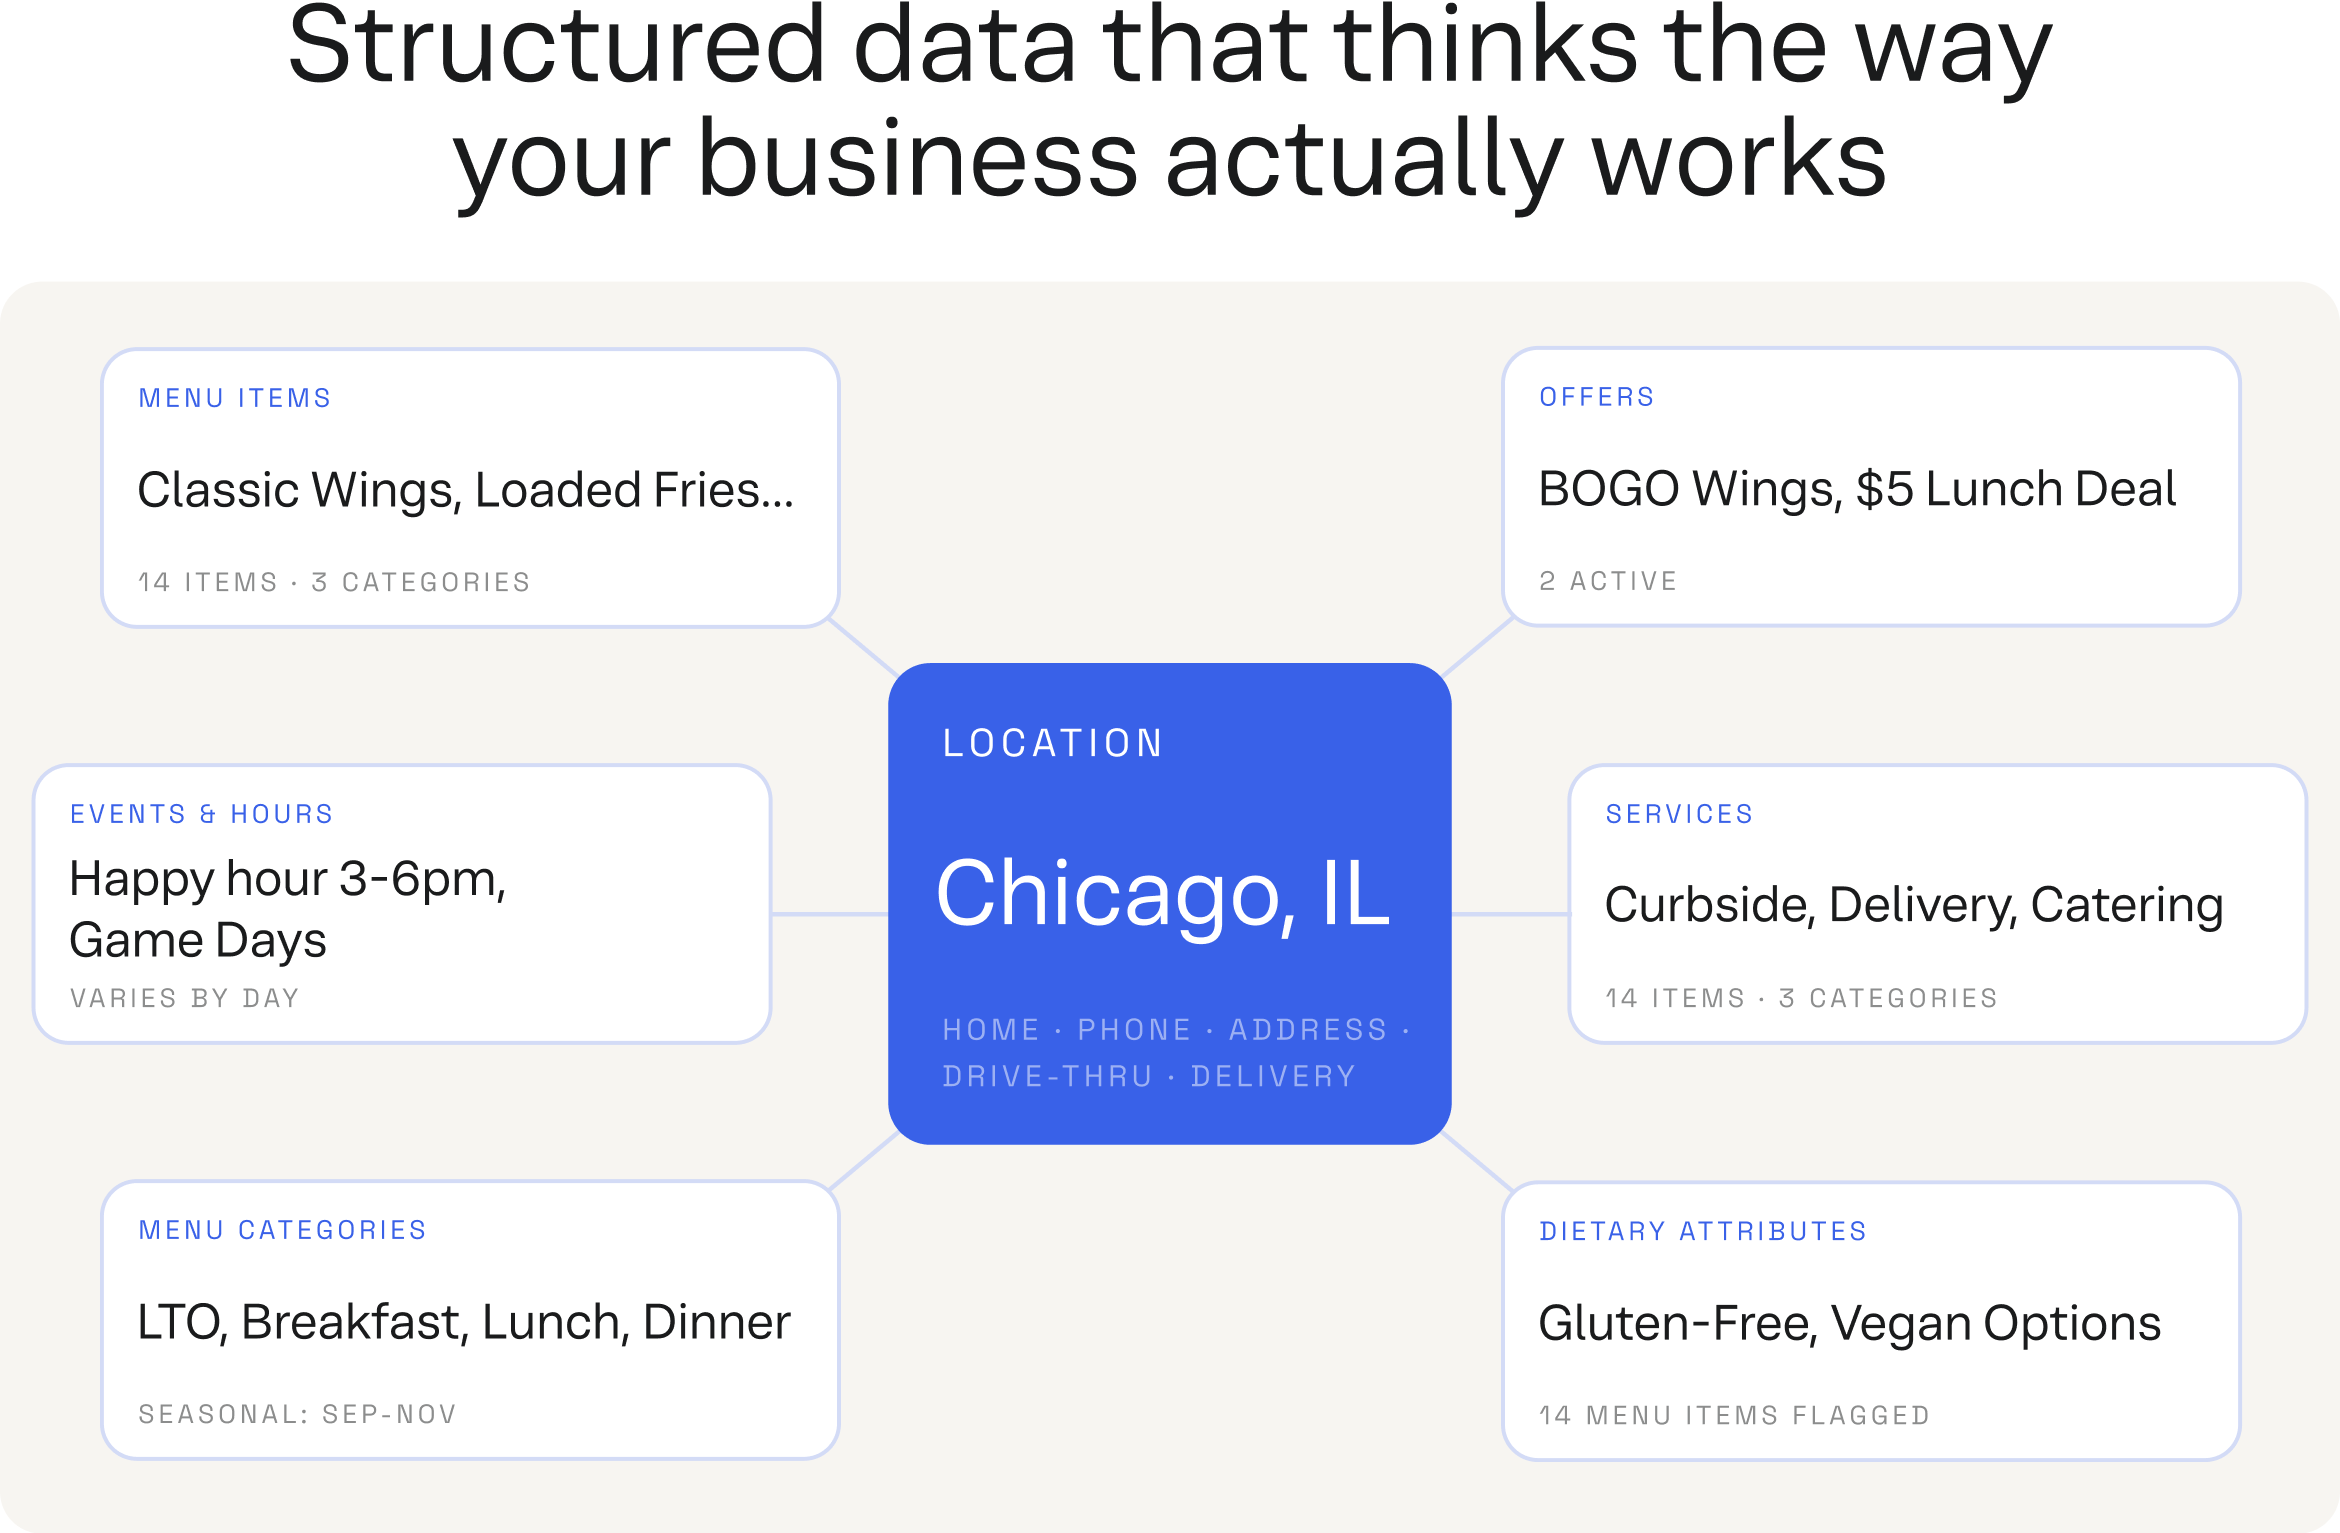
Es handelt sich jedoch nicht um eine Lösung, die man einmal einrichtet und dann vergessen kann.
Anschließend arbeiten Datenagenten kontinuierlich innerhalb des Knowledge Graphs, um Daten aus verschiedenen Quellen miteinander zu verknüpfen, sie in großem Umfang zu überprüfen und Unstimmigkeiten automatisch aufzudecken. Wenn sich beispielsweise die Öffnungszeiten eines Standorts in einem Kassensystem ändern, können Datenagenten diese Aktualisierung in den Knowledge Graph übernehmen. Wird an einem Standort eine neue Dienstleistung hinzugefügt, der Knowledge Graph diese jedoch an einem anderen Standort anzeigt, melden die Agenten diese Diskrepanz. Sie optimieren und pflegen diese zuverlässige Datenquelle und sorgen so dafür, dass alle Fakten langfristig korrekt und aktuell bleiben.
Diese einheitlichen und aktuellen Kernangaben zum Unternehmen (Name, Adresse, Öffnungszeiten, Telefonnummer, Dienstleistungen) liefern der KI die notwendigen Informationen, um die Existenz einer Marke zu erkennen und ihr Vertrauen zu schenken.
Doch eine solche zuverlässige Datenquelle ist nur ein Teil der Lösung. Diese Quelle muss jeden Endpunkt erreichen, an dem die KI nach Antworten für die Kundschaft sucht – und sie muss alle gleichzeitig erreichen.
Klicken Sie hier, um den dritten Beitrag dieser Reihe zu lesen.