Listings
Nouveaux indicateurs clés pour les problèmes affectant les listings
Le statut Non synchronisé des problèmes affectant les listings est désormais réparti entre deux indicateurs clés :
- Action requise : comptabilise les problèmes bloquants (par exemple, la déconnexion de votre compte associé) sur Google, Apple, Facebook, Bing et Yelp. Il s'agit de problèmes critiques qui doivent être corrigés pour assurer la bonne synchronisation des informations entre Yext et l'annuaire.
- Optimiser : couvre les problèmes non bloquants (par exemple, une description dépassant le nombre maximal de caractères) sur ces cinq mêmes annuaires, ainsi que les problèmes bloquants et non bloquants sur le reste du réseau d'annuaires.
En distinguant les corrections urgentes des autres problèmes, les marques peuvent concentrer leurs efforts sur les actions les plus importantes.
Pour en savoir plus, lisez l'article Consulter les statuts des listings.
Publishers
Yext s'intègre à Justdial
Yext s'intègre à Justdial, une importante plateforme de recherche locale pour les établissements situés en Inde. Cette intégration est disponible pour les établissements situés en Inde, dans toutes les catégories Yext.
Retrait de l'outil de vérification de l'exactitude des listings pour Bing
Nous retirons Verifier, l'outil de vérification de l'exactitude des listings pour Bing, car Bing ne le prend plus en charge.
Reviews & User-Generated Content
Affichage des contenus multimédias des avis Google dans le suivi des avis
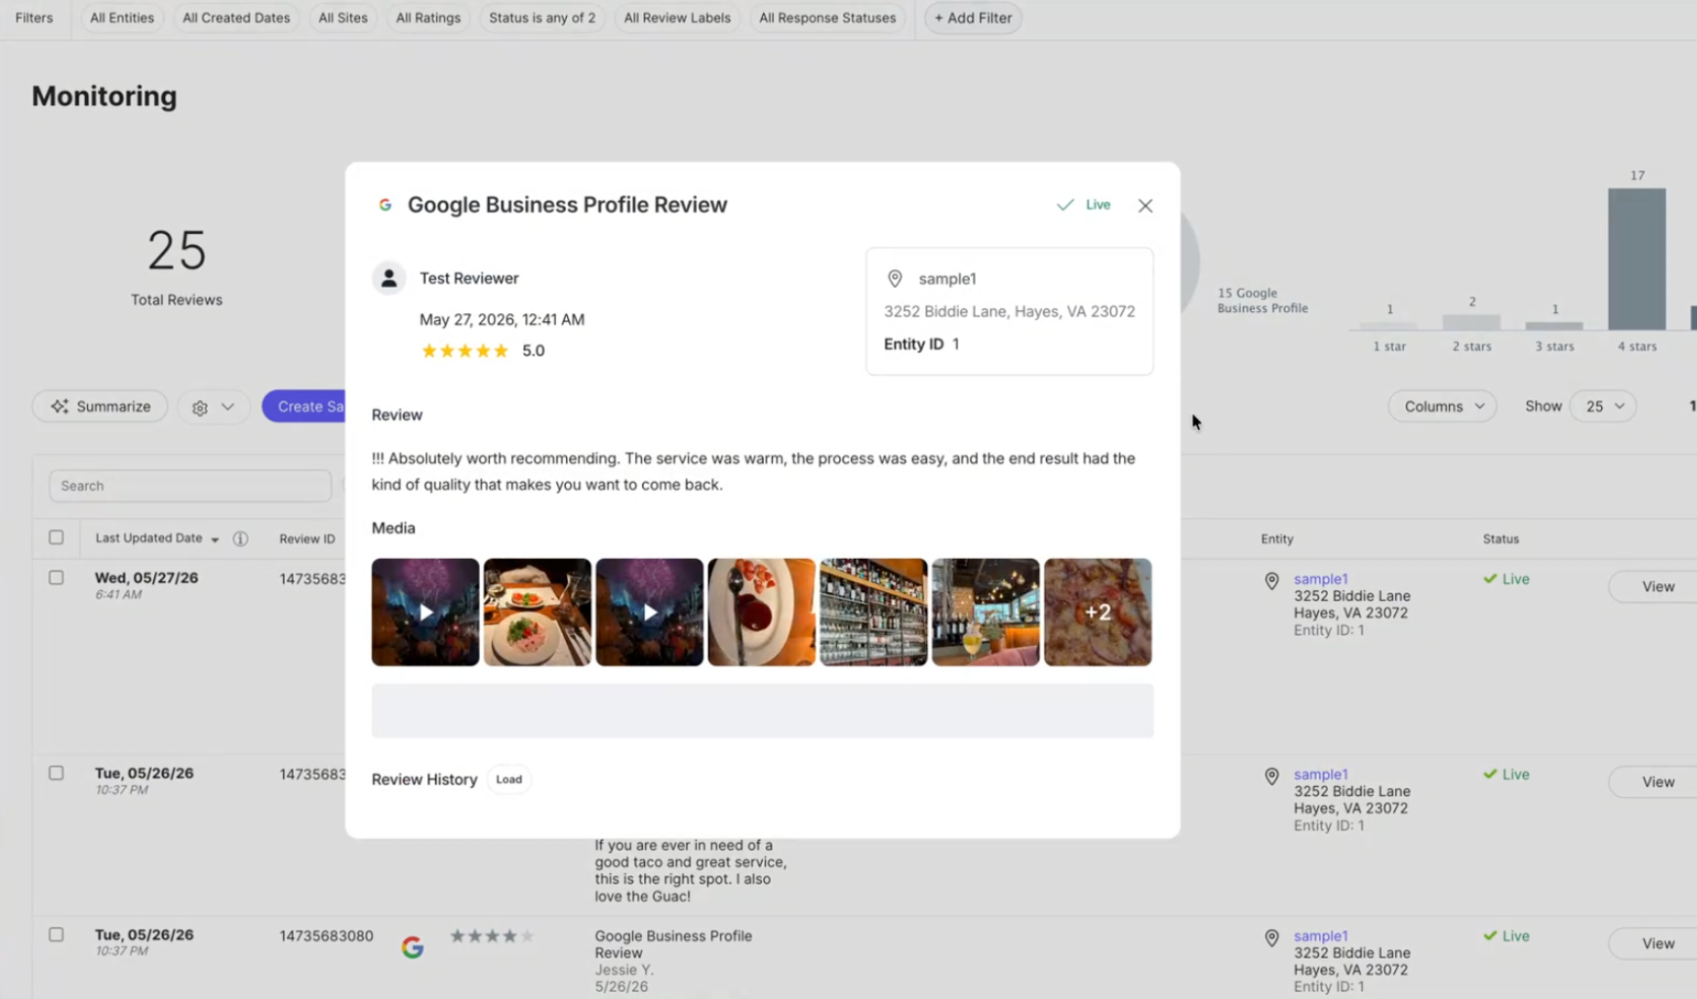
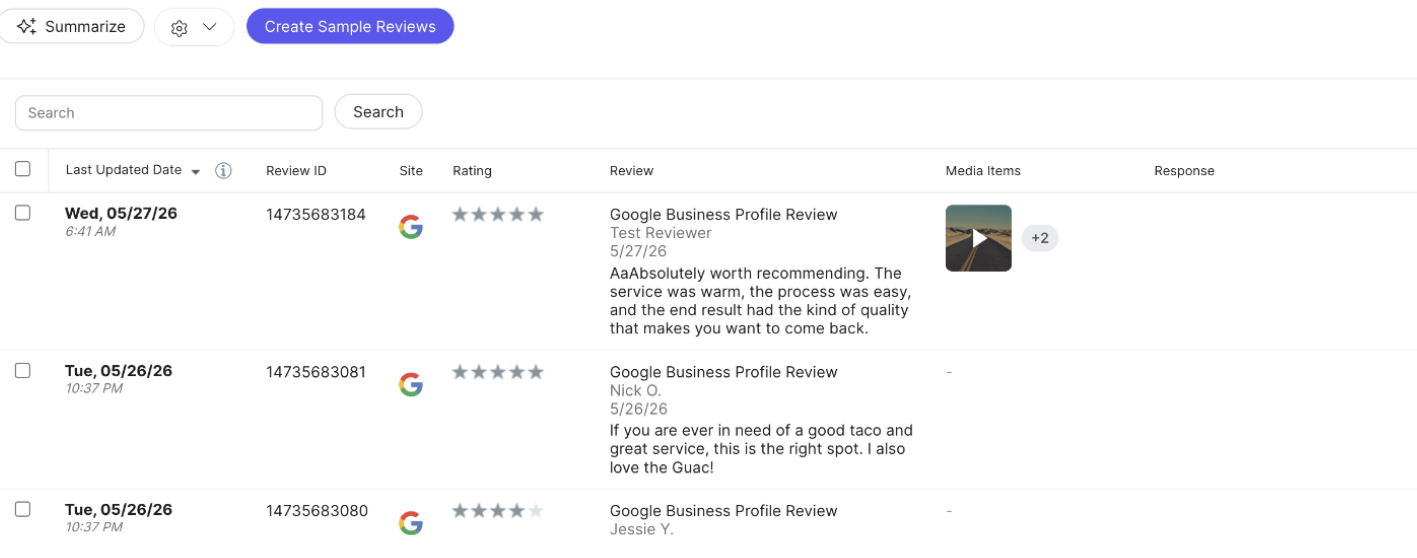
Yext importe et affiche désormais les photos et vidéos jointes aux avis Google directement avec l'avis associé dans la fenêtre modale Détails de l'avis. Les équipes disposent ainsi d'une vue d'ensemble complète des retours clients sans avoir à passer par la fiche d'établissement Google. Auparavant, Yext pouvait uniquement importer le texte, les notes et les métadonnées des avis.
Configuration de la génération d'avis au niveau de l'entité
Les clients peuvent désormais configurer les paramètres de génération d'avis pour chaque entité, en remplaçant les paramètres par défaut définis au niveau du compte pour certains établissements. Ces paramètres permettent notamment aux organisations de définir, pour certaines entités, un nombre maximal d'e-mails d'invitation afin d'éviter que les entités qui en envoient beaucoup n'épuisent les limites partagées. Les paramètres définis au niveau de l'entité s'appliquent champ par champ. Tout champ qui n'est pas remplacé continue donc d'hériter du paramètre défini au niveau de l'entreprise. Pour configurer ces paramètres, sélectionnez une entité dans le Knowledge Graph et modifiez les valeurs de la section Génération d'avis.
Abonnement requis pour les avis Trustpilot
Trustpilot exige un abonnement payant actif pour suivre les avis et y répondre depuis des plateformes tierces. Afin d'assurer la parfaite conformité de notre intégration avec cette exigence, Yext commencera à l'appliquer à tous les domaines à compter du 30 octobre 2026.
Après cette date, les comptes sans abonnement actif perdront l'accès aux avis Trustpilot et à l'historique des avis.
Social
Champs intégrés dans les réponses aux commentaires et aux MP
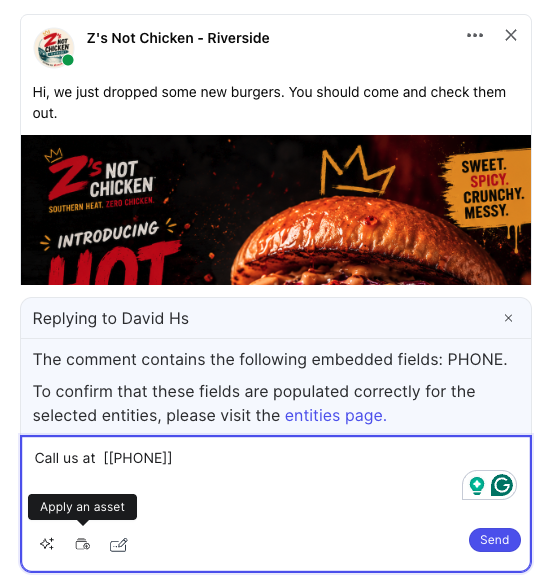
Les ressources textuelles utilisées pour répondre aux commentaires et aux messages privés prennent désormais en charge les champs intégrés du Knowledge Graph. Lorsque vous sélectionnez une ressource pour répondre à un commentaire ou à un message privé, tout champ intégré à cette ressource (par exemple, mainPhone) est automatiquement renseigné à partir de l'entité concernée. Cela accélère les workflows de réponse et les rend plus cohérents à grande échelle, en particulier pour les équipes qui gèrent un volume important d'interactions sur les réseaux sociaux pour plusieurs établissements.
Consultez la documentation sur les commentaires et les messages privés pour en savoir plus.
Trier les publications sur les réseaux sociaux par date dans l'API Yext
Le point de terminaison Posts: List prend désormais en charge le paramètre de requête sortBy, qui permet aux développeurs de choisir si les résultats sont renvoyés par date de création, de la plus récente à la plus ancienne ou de la plus ancienne à la plus récente. L'ordre par défaut reste de la plus récente à la plus ancienne. Les intégrations existantes ne sont donc pas affectées. Lors de la pagination, la même valeur sortBy doit être transmise avec chaque jeton de page. Pour utiliser ce nouveau paramètre, vous devez utiliser la valeur de vparam 20260812 ou une valeur ultérieure.
Sélection d'un champ d'entité pour l'URL d'utilisation de l'offre dans les publications d'offre Google
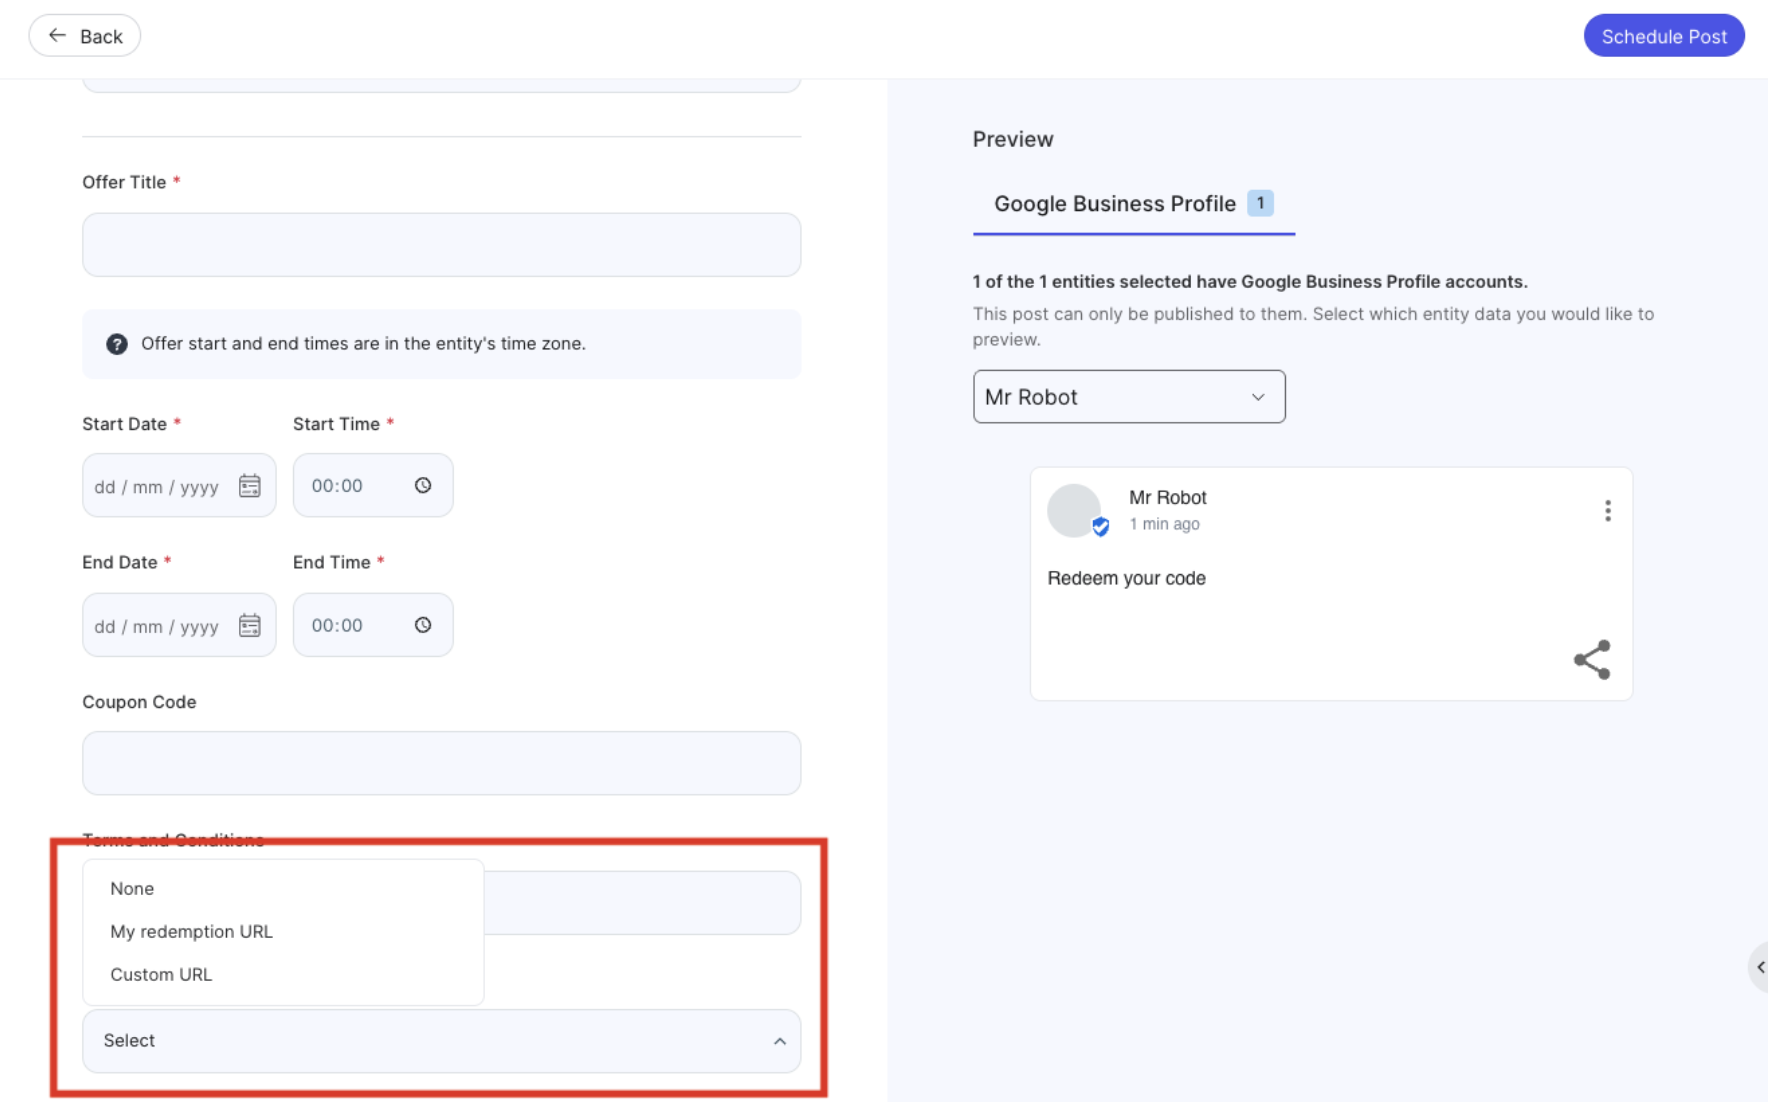
Les publications d'offres Google prennent désormais en charge des URL d'utilisation dynamiques associées à des champs d'entité du Knowledge Graph, ce qui facilite la publication groupée pour les marques gérant plusieurs établissements. Auparavant, l'URL d'utilisation devait être une valeur statique unique. Les équipes devaient donc soit renoncer aux publications d'offres, soit les publier établissement par établissement. Les utilisateurs peuvent désormais sélectionner un champ d'URL dans le Knowledge Graph, et la plateforme récupère automatiquement l'URL correspondant à chaque établissement.
Nouvelle autorisation de chargement d'éléments multimédias pour les publications sur les réseaux sociaux
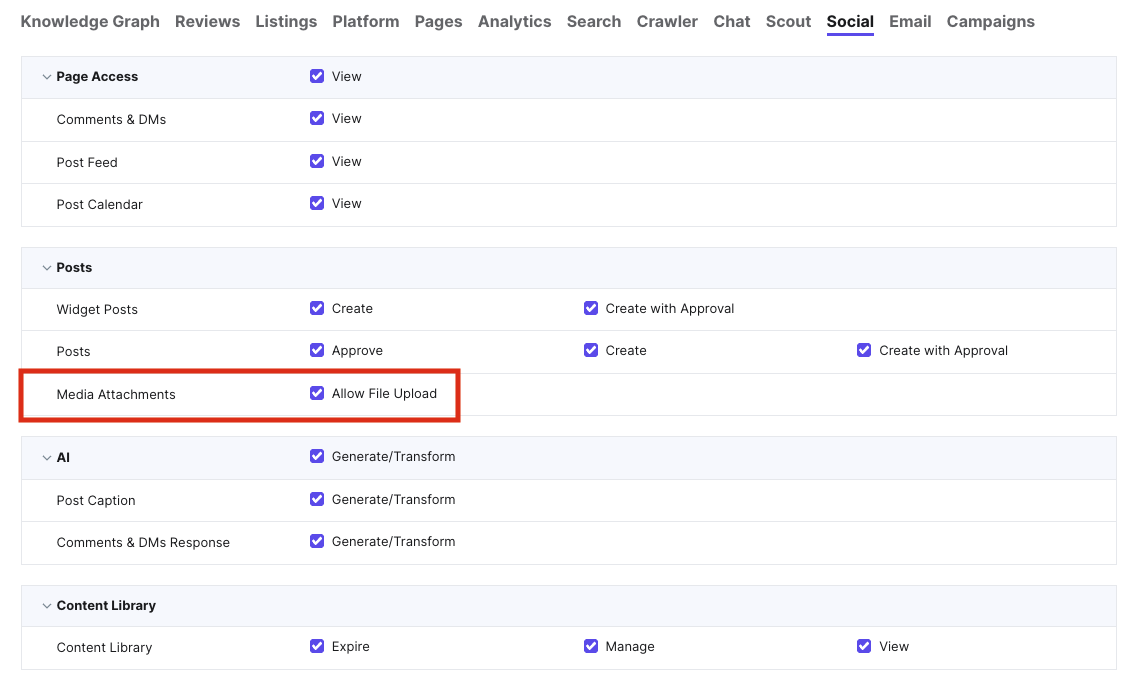
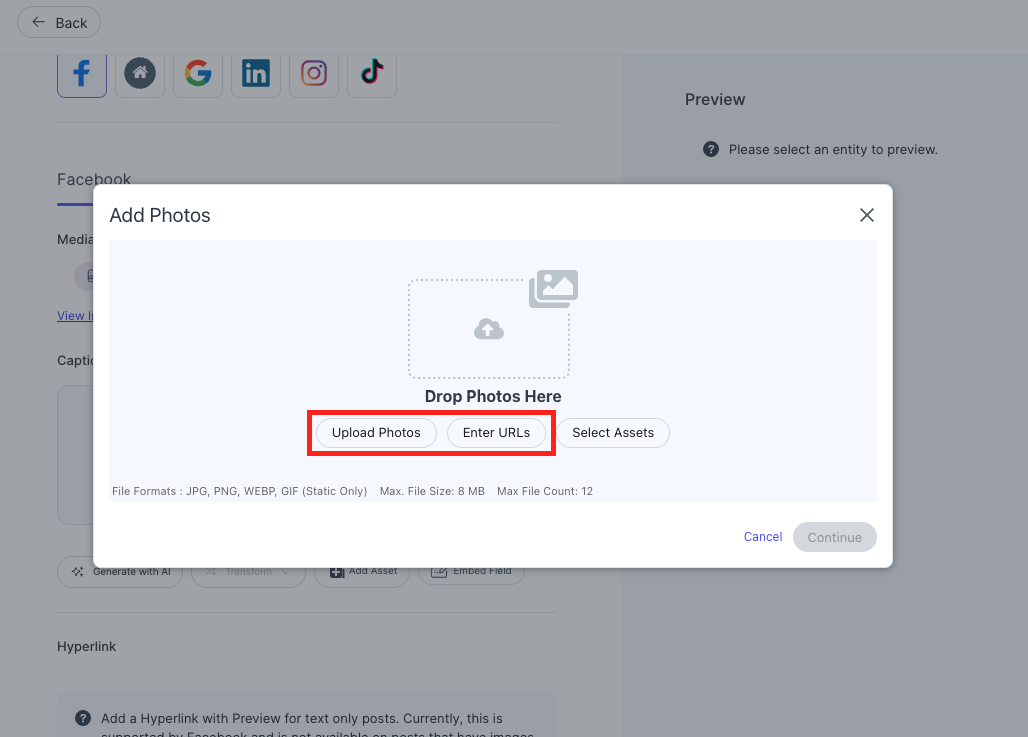
Une nouvelle autorisation au niveau des rôles, Pièces jointes multimédias > Autoriser le chargement de fichiers, permet de déterminer si certains utilisateurs sont autorisés à joindre des médias (c'est-à-dire des images et des vidéos) depuis leur ordinateur local ou une URL publique lors de la création de publications sur les réseaux sociaux.
Lorsque cette autorisation est désactivée pour un rôle, les options de chargement local et d'URL publique sont entièrement masquées dans l'éditeur de publication. Les utilisateurs peuvent alors uniquement sélectionner des médias dans la bibliothèque d'actifs approuvés de l'organisation. Les organisations disposent ainsi d'un mécanisme de contrôle strict pour assurer la gouvernance de leur marque et garantir la conformité, en veillant à ce que les responsables d'établissement et les utilisateurs sur le terrain publient uniquement du contenu préapprouvé.
Vous pouvez modifier cette autorisation en accédant à Paramètres du compte > Rôles. Après avoir sélectionné le rôle à modifier, cliquez sur l'onglet Social et faites défiler la page jusqu'à Publications. Cette autorisation est cochée par défaut (le chargement de fichiers est autorisé) pour tous les rôles existants. Vous devez la décocher explicitement pour les rôles que vous souhaitez restreindre.
Pour en savoir plus, consultez les autorisations de chargement de médias pour les publications sur les réseaux sociaux.
Scout
Pages de performances AEO et SEO
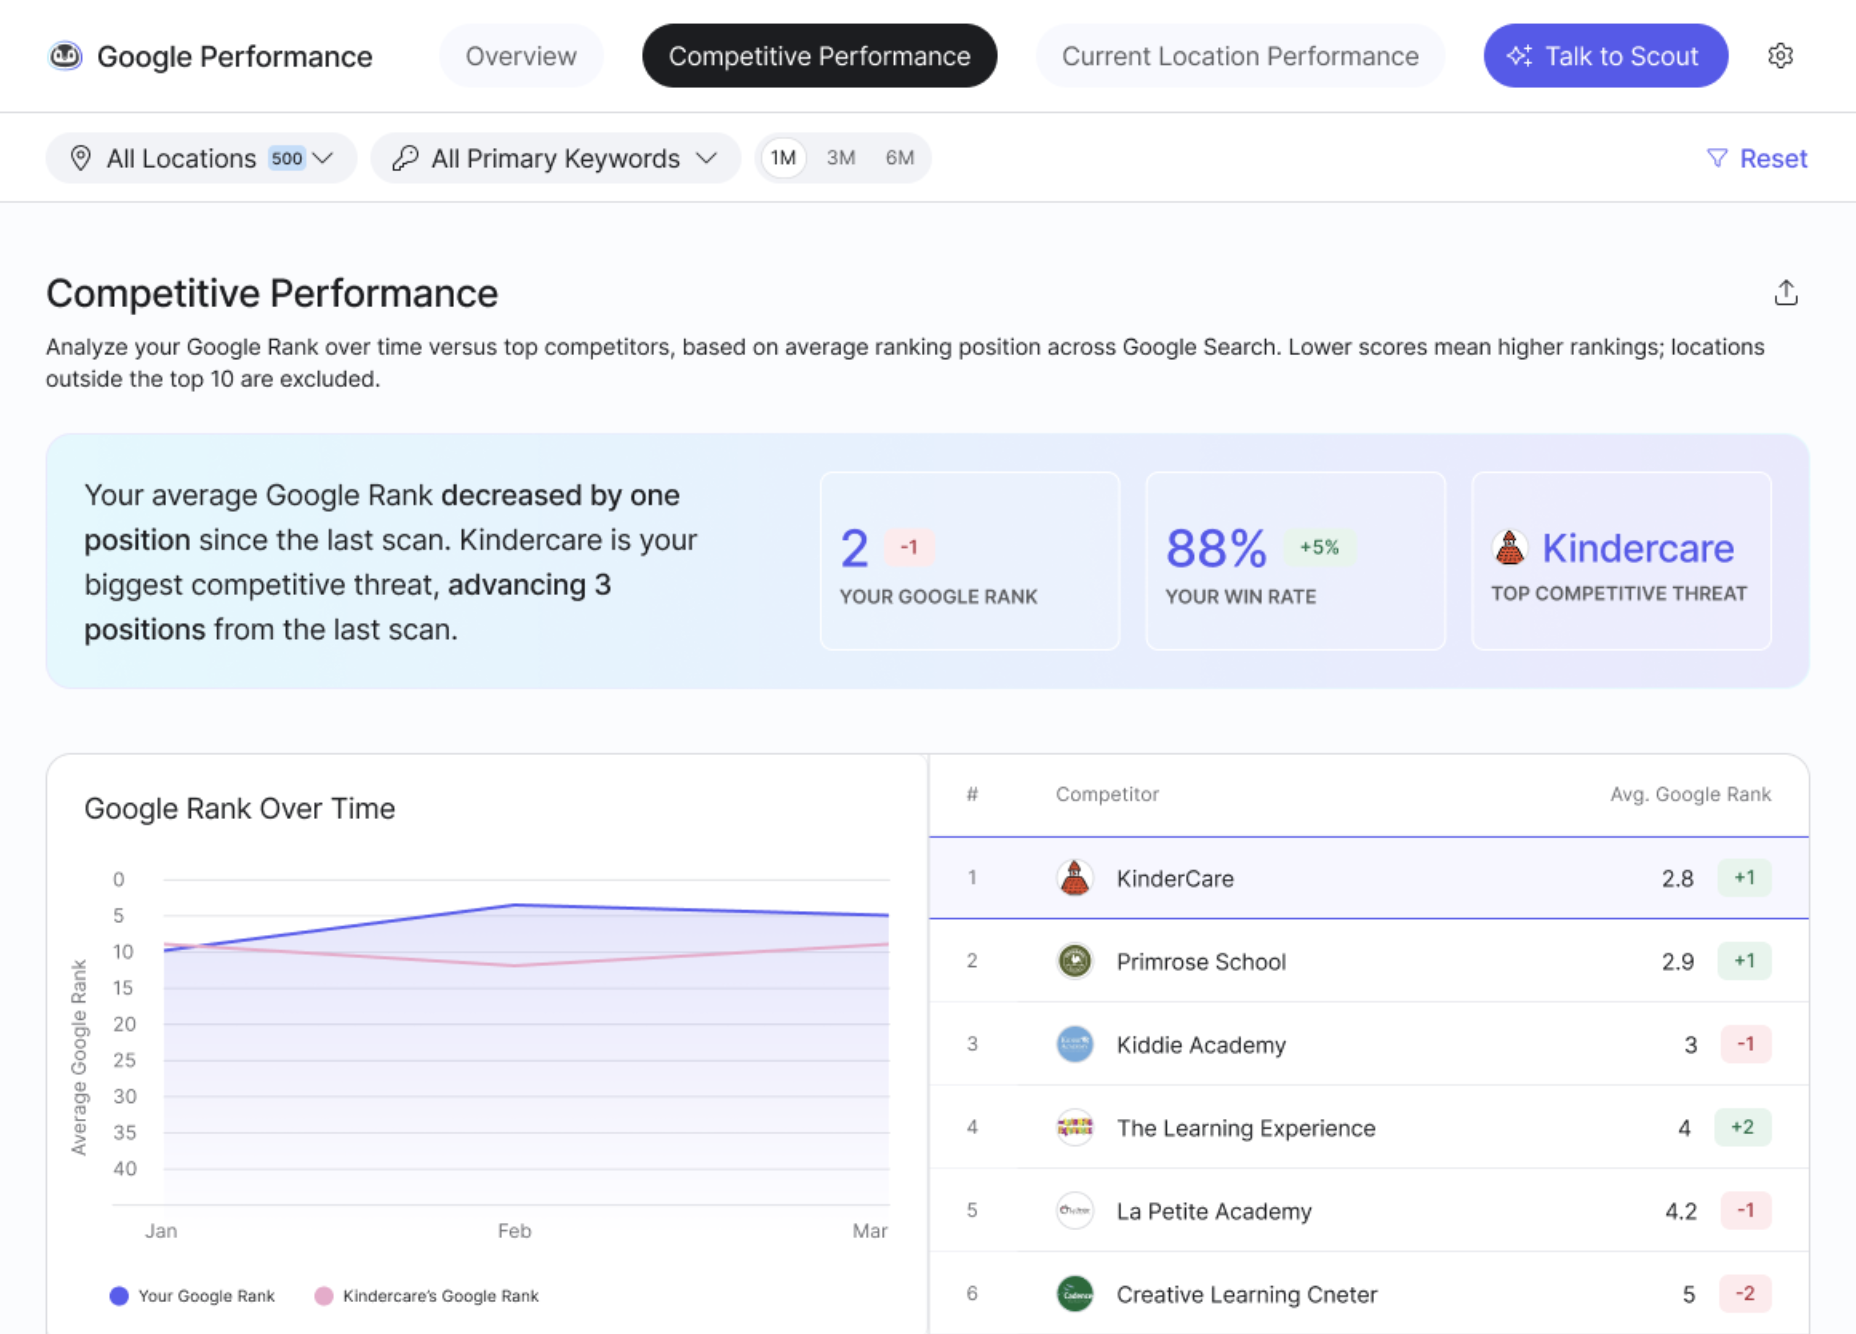
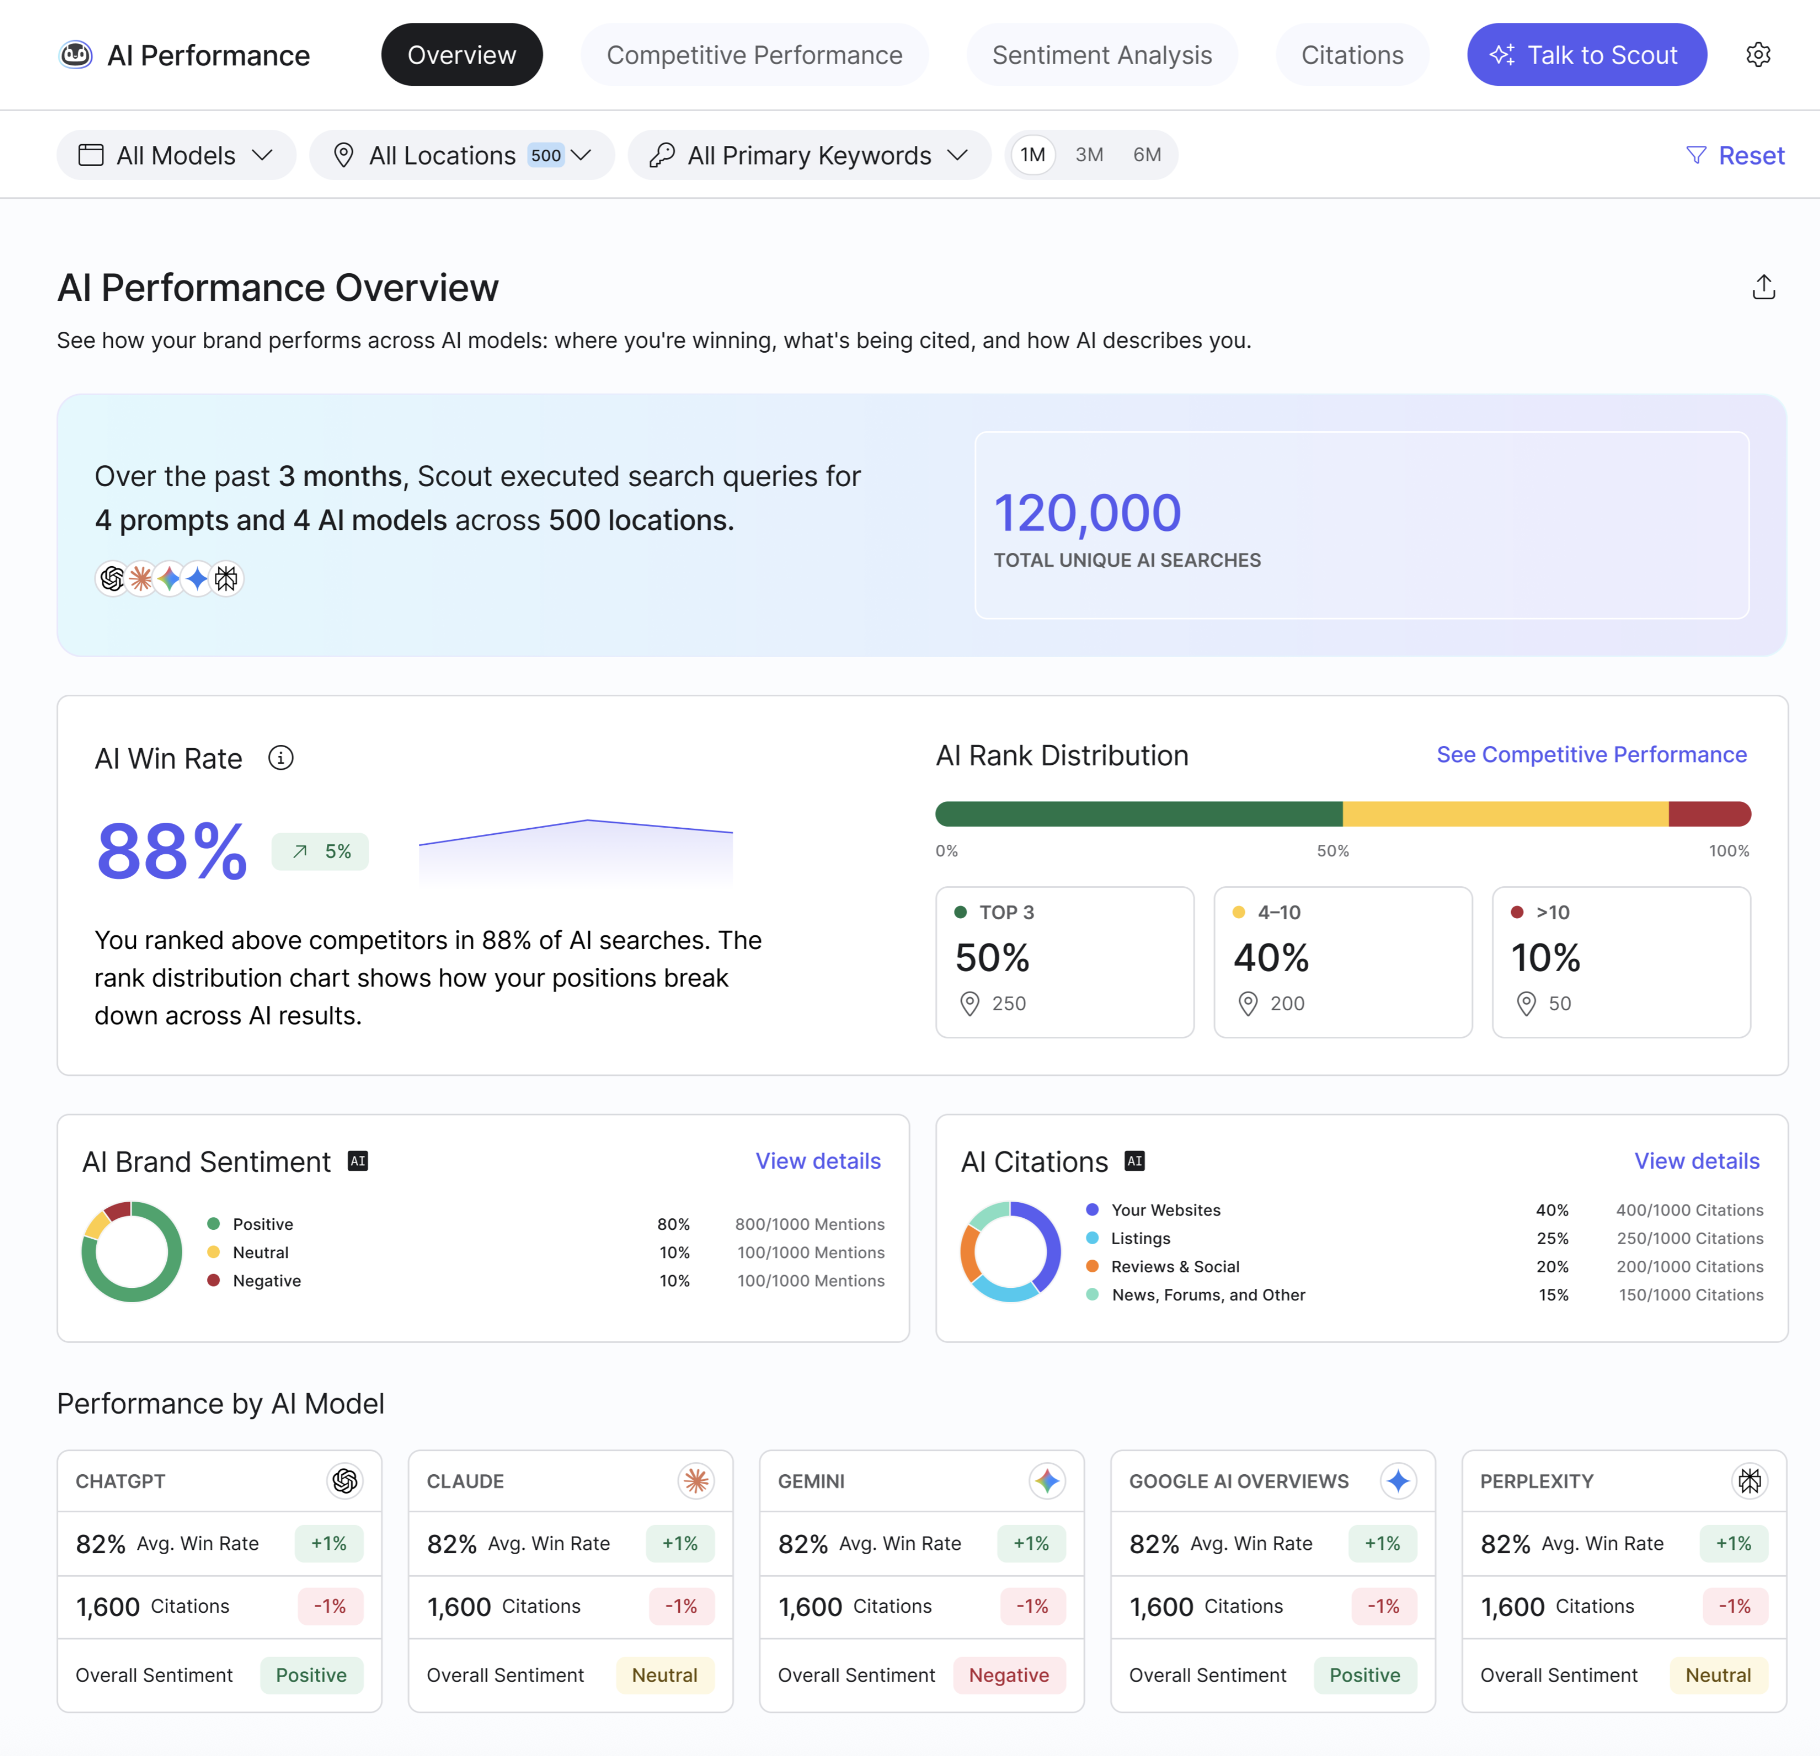
Scout propose désormais des pages détaillées Performances Google (SEO) et Performance IA (AEO), qui centralisent les données permettant aux clients de mesurer et d'améliorer leur visibilité dans la recherche traditionnelle et par IA. Des fonctionnalités d'exploration complètes ainsi que des exports de données sont disponibles pour les clients titulaires d'une offre Scout payante. Les KPI de base restent quant à eux accessibles avec la version gratuite. Ces pages remplacent les anciennes pages dédiées au Rapport de visibilité et à l'analyse détaillée des indicateurs. Voici ce que comprend chacune d'elles :
- Performances Google : centralise les performances des mots-clés et des concurrents, les outils d'exploration des indicateurs par établissement et les tendances de classement des concurrents. La page inclut de nouvelles répartitions par mot-clé et par établissement du taux de réussite et du classement Google moyen.
- Performance IA : regroupe le taux de réussite dans les résultats de l'IA, le classement dans les réponses de l'IA, l'analyse du sentiment envers la marque et les citations de la marque par l'IA. Cette page introduit le suivi des Aperçus IA de Google, permettant aux utilisateurs de filtrer les données par modèle.
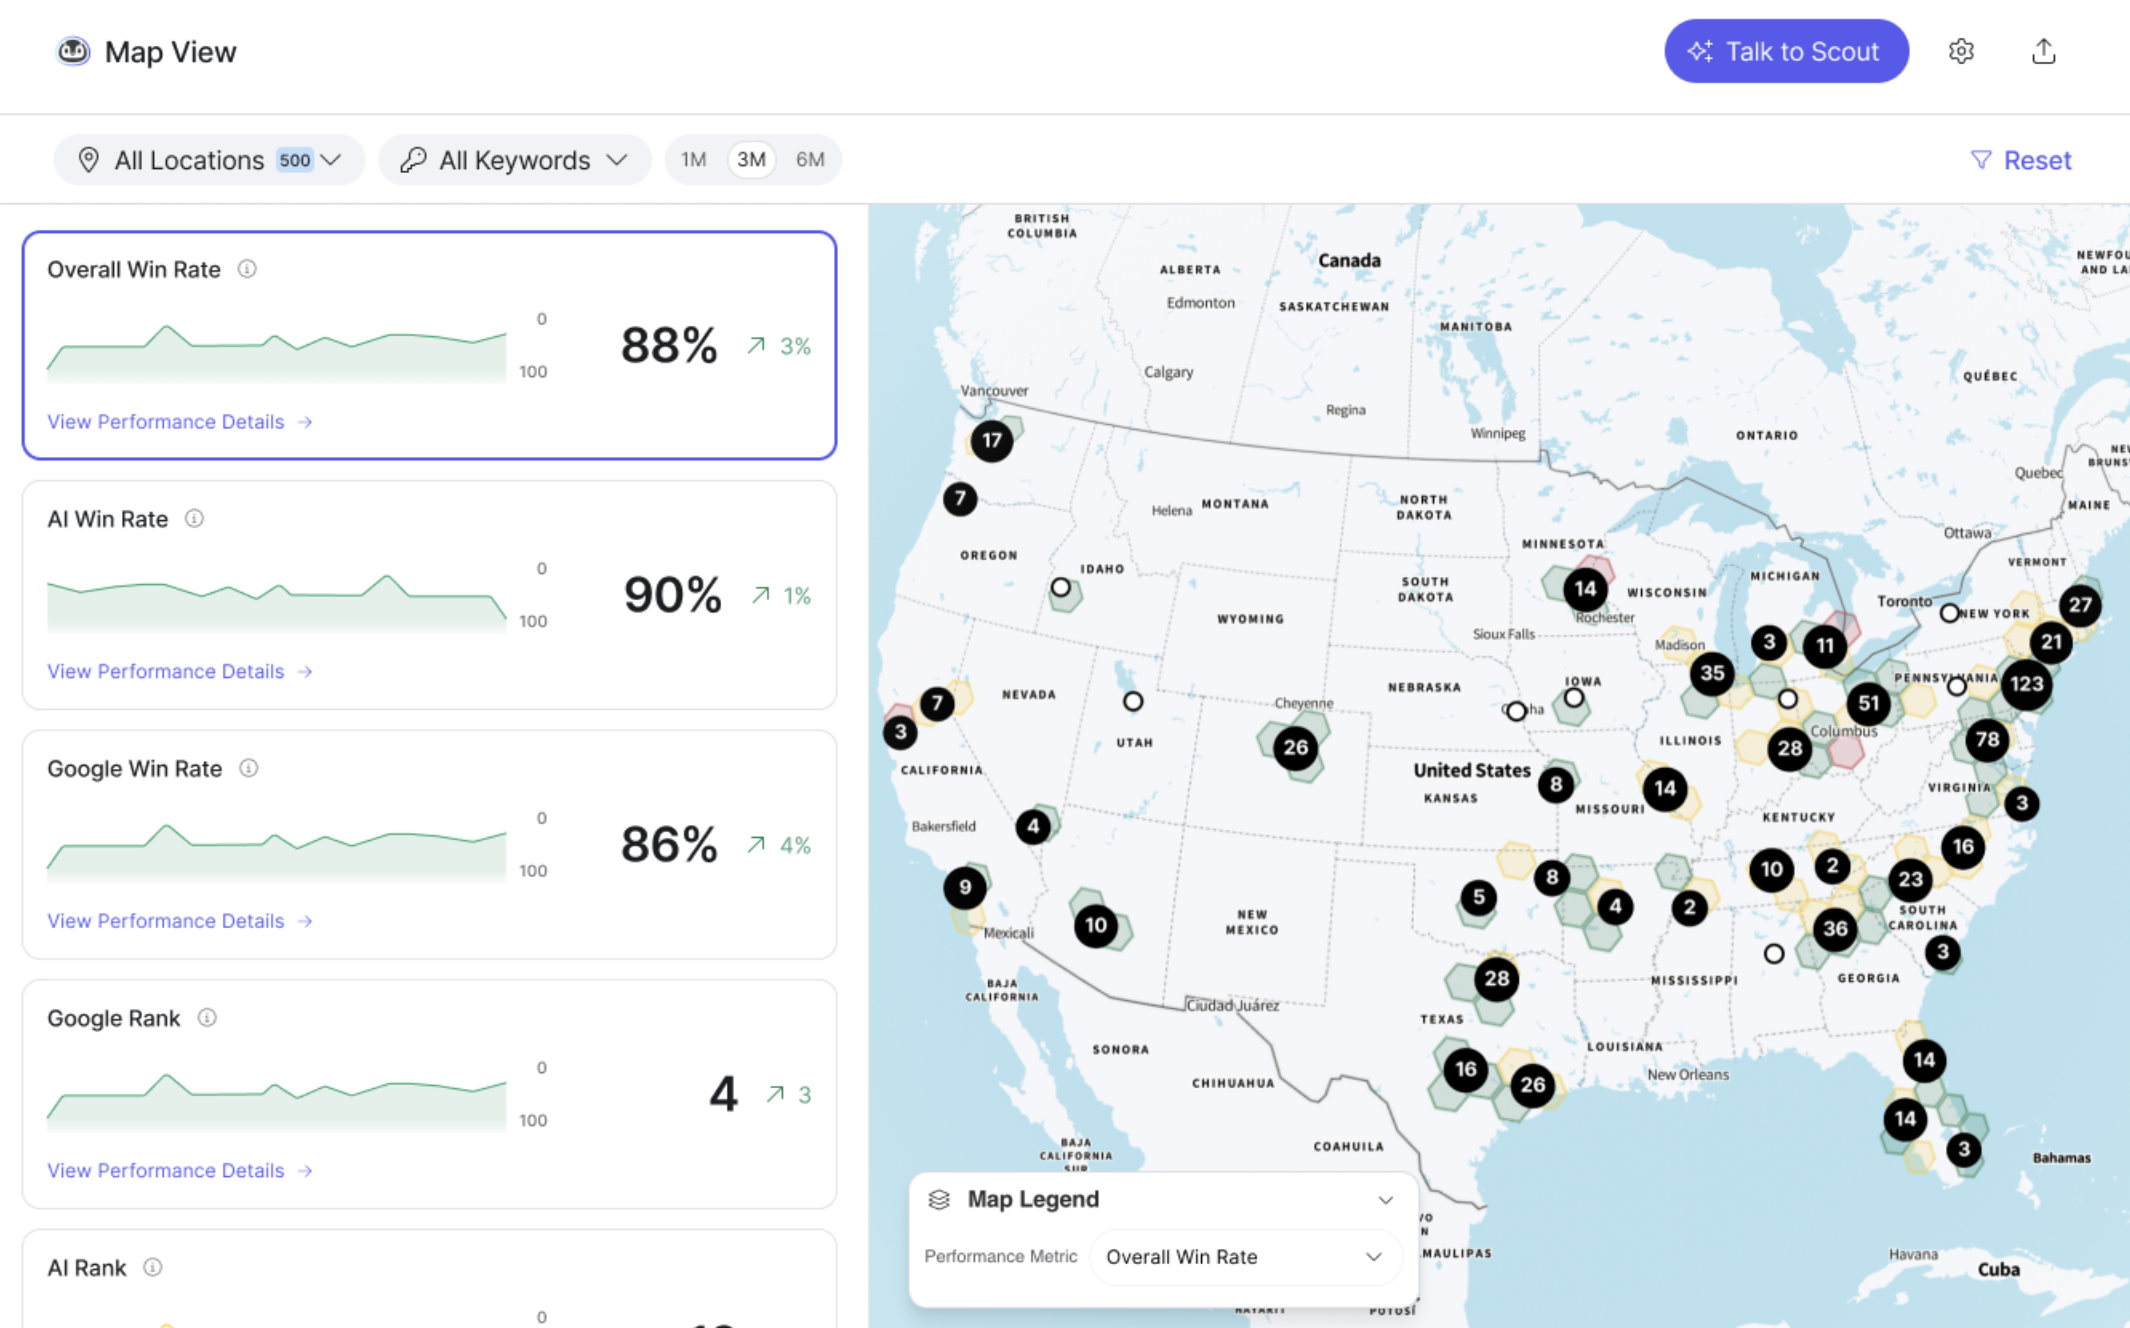
- Vue de carte : les tuiles de la carte affichent désormais le taux de réussite comme indicateur principal de la visibilité globale, auprès de l'IA et sur Google.
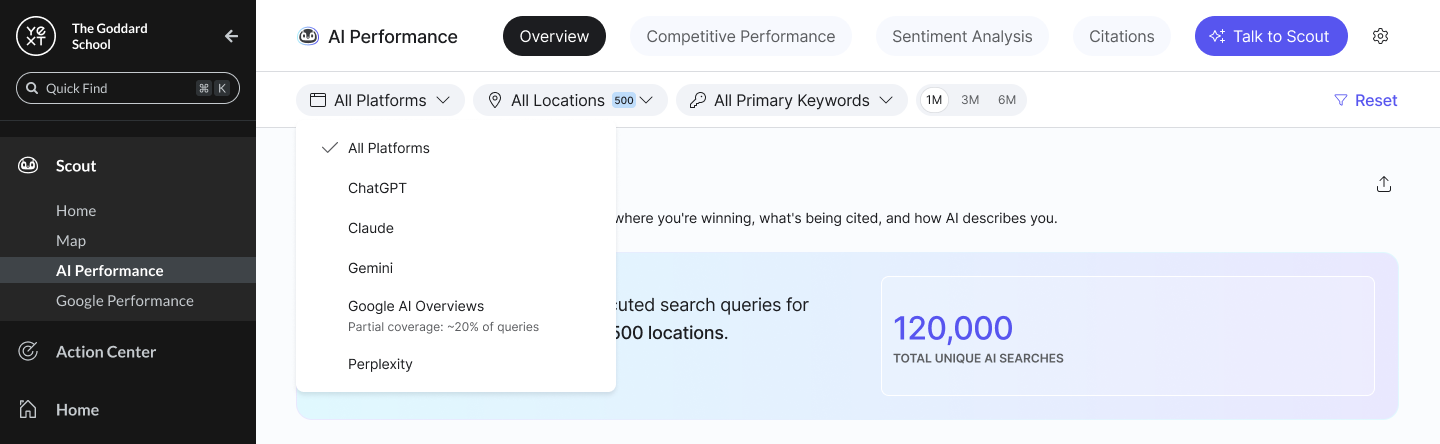
Ajout des Aperçus IA de Google comme source de collecte de données
Avec l'ajout des Aperçus IA de Google comme source de collecte de données, Scout offre désormais une visibilité sur la façon dont les marques apparaissent dans les résumés générés par l'IA dans les résultats de Google. Les clients peuvent ainsi suivre leurs performances et leurs citations dans l'une des nouvelles expériences de recherche IA les plus importantes, aux côtés de modèles existants comme ChatGPT et Gemini. Ces données sont intégrées à l'ensemble de l'expérience Scout, notamment dans l'interface utilisateur, l'API et les exports d'évaluation de la qualité de l'IA.
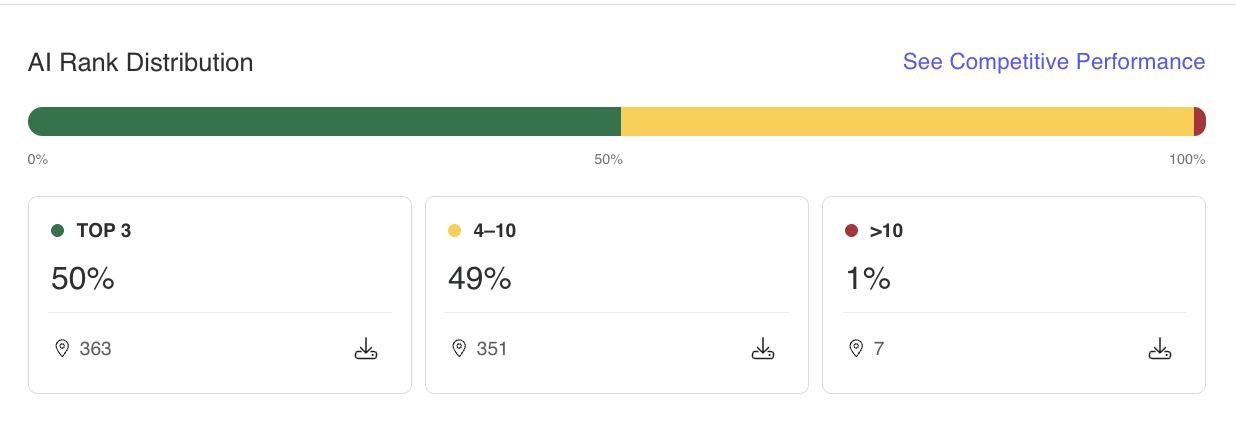
Export des tranches de classement
Les pages Vue d'ensemble des performances IA et Vue d'ensemble des performances Google permettent désormais aux utilisateurs d'exporter les données associées à chaque tranche de classement (par exemple, les rangs 1 à 3 ou 4 à 10) directement depuis la vue Répartition du classement. Cliquer sur le bouton d'exportation d'une carte de classement génère un fichier CSV contenant l'ensemble des entités et des mots-clés de la tranche concernée, ainsi que des détails tels que le rang, l'adresse et l'horodatage de l'exécution.
Sélecteur de période flexible
L'interface utilisateur de Scout inclut désormais un sélecteur de période plus flexible qui remplace les options de filtre fixes précédentes. Les utilisateurs peuvent sélectionner un mois de fin précis et choisir une période rétrospective de 1, 3 ou 6 mois, ce qui facilite l'analyse des performances sur la période requise pour les rapports. Le filtre mis à jour est également pris en charge dans la couche MCP.
Améliorations apportées à « Discuter avec Scout »
L'expérience de chat « Discuter avec Scout » a été mise à jour pour fournir des réponses plus courtes et plus précises, s'appuyant sur un ensemble élargi de données du compte en temps réel. Voici les nouveautés :
- Analyse le texte des avis pour identifier les thèmes, la visibilité des fiches, le sentiment envers la marque dans les réponses de l'IA et les taux de réussite en comparaison directe
- Affiche des cartes d'action qui renvoient directement au Centre d'action pour permettre aux utilisateurs de passer à l'action à partir de ces informations sans quitter le chat
- Recommande les prochaines étapes les plus pertinentes en fonction de la conversation pour faire avancer les workflows
- Signale ce qu'il ne peut pas vérifier afin d'améliorer la fiabilité des informations qu'il fournit
Consultez la documentation sur l'écran d'accueil Scout pour en savoir plus.
Search
Affichage des catégories d'échec des GDA
Les journaux des réponses génératives distinguent désormais différents types d'absence de réponse, ce qui permet aux équipes de mieux comprendre pourquoi aucun résumé n'a été renvoyé. Auparavant, tous les échecs étaient regroupés. Les journaux affichent désormais deux catégories d'échec supplémentaires :
- Aucune réponse trouvée : cas dans lesquels le LLM n'a pas pu générer de résumé à partir des entités disponibles et des règles de synthèse.
- Erreur serveur : cas dans lesquels le résumé n'est pas affiché, car le processus de synthèse n'a pas pu être mené à bien dans un délai satisfaisant et a été annulé.
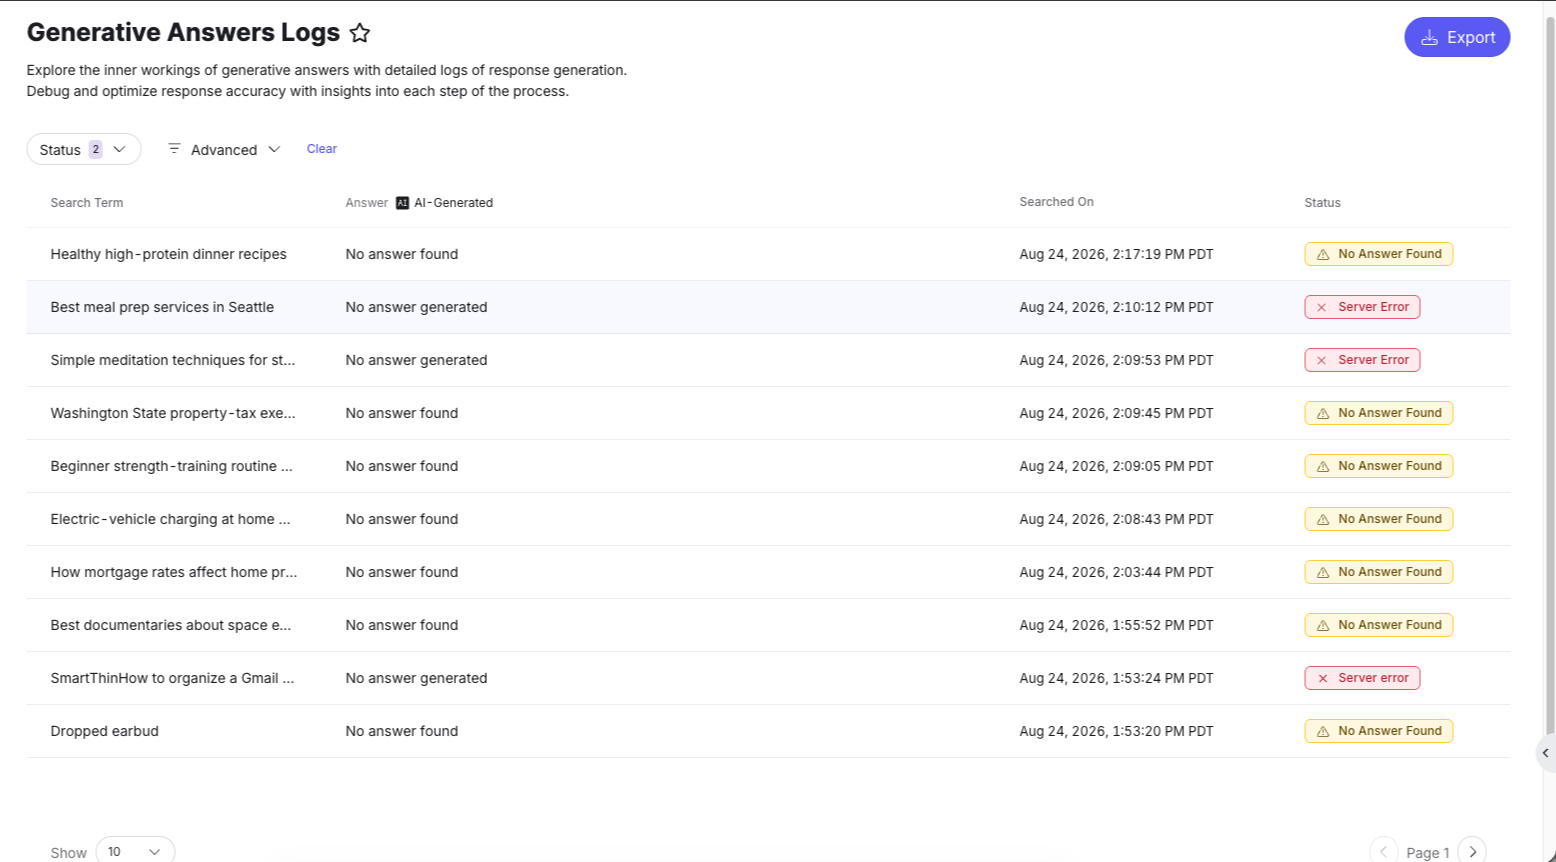
Pour en savoir plus, consultez l'article Journaux des réponses génératives.
Suivi des évaluations positives et négatives dans les GDA
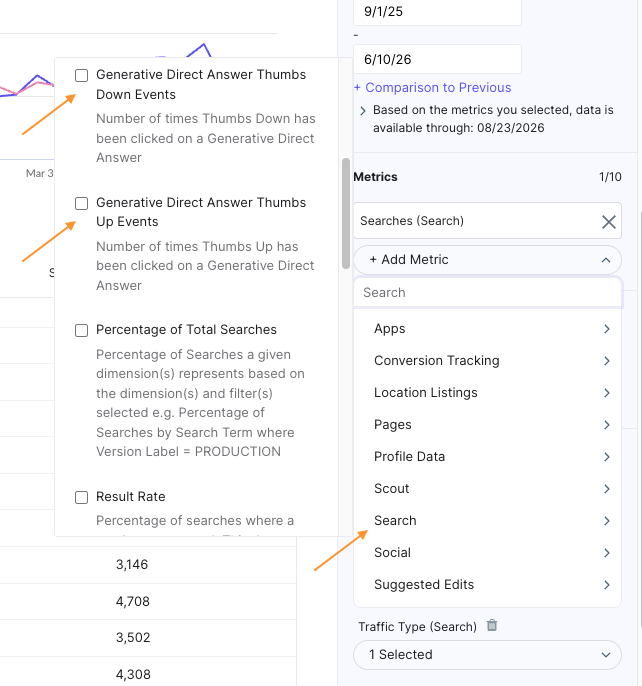
Les réponses génératives affichent des icônes en forme de pouce levé et de pouce baissé à la fin de chaque extrait, offrant ainsi aux utilisateurs finaux un moyen direct d'indiquer si la réponse générée par l'IA leur a été utile. Les données d'interaction sont collectées et disponibles dans Analytics. Vous pouvez ainsi suivre les événements Pouce levé et Pouce baissé dans les rapports afin d'évaluer la qualité et la précision du contenu généré au fil du temps.
Améliorations de la visibilité des journaux de recherche pour les GDA
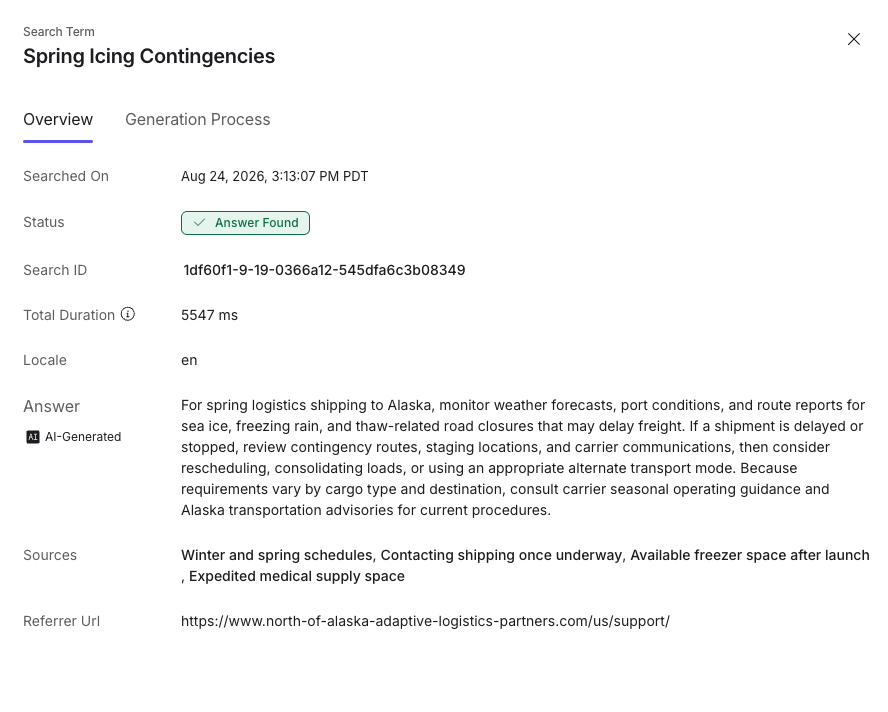
La page de détails des résultats de recherche affiche désormais l'URL de provenance des résultats de recherche associés aux réponses génératives directement dans l'interface de la plateforme. Les équipes peuvent ainsi déterminer de manière autonome l'origine d'une recherche et diagnostiquer les problèmes de qualité des réponses. Lors de l'exportation des journaux de recherche GDA dans un fichier .csv, l'URL de provenance, les sources et un lien vers les détails du journal sont également inclus.
Pour en savoir plus, consultez l'article Journaux des réponses génératives.